AnalysesDécryptage•8 min de lecture
Quelles sources les réponses des IA citent-elles ? Ce qu'il faut regarder au-delà du lien
Un lien affiché n'est ni une visite, ni une preuve. Notre simulation sépare trois questions : l'assistant cite-t-il une source, de quel type, et cette source soutient-elle vraiment ce qu'elle est censée prouver ?
AnalysesDécryptage•7 min de lecture
L'intention de la question change qui est cité : découvrir, comparer, se faire recommander, s'informer
Dans notre scénario, une question d'information ne fait nommer une entreprise que dans 32,8 % des réponses, contre 81,8 % pour une question de découverte. Avant de viser « la visibilité IA », il faut savoir à quelles questions on veut répondre.
AnalysesDécryptage•7 min de lecture
Local, national, international : qui occupe la réponse quand l'IA répond ?
Dans notre scénario, un acteur local occupe la première place dans 41,6 % des réponses du commerce local, mais dans 14 % seulement pour les logiciels. La place d'une petite structure dépend d'abord de son secteur.
AnalysesDécryptage•7 min de lecture
Le temps libéré par l'IA ne vaut pas du cash
Dans notre modèle, l'offre commerciale assistée par un outil généraliste dégage 124 € de valeur mensuelle à 70 €/h — mais seulement 12 € de trésorerie. L'écart entre les deux est la décision.
AnalysesDécryptage•6 min de lecture
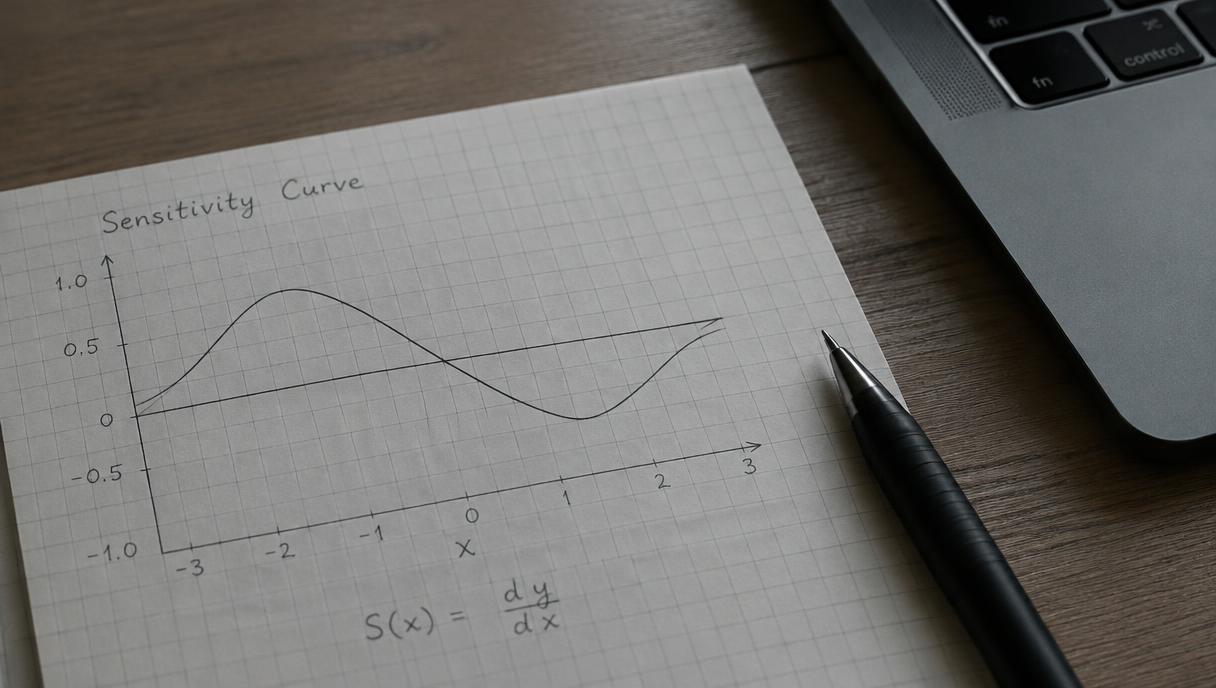
Une conclusion de rentabilité est fragile par construction
Le même outil, le même workflow : rentable à 25 % de gain, surcoût en dessous. Notre modèle balaie les hypothèses pour montrer exactement où chaque conclusion bascule.
AnalysesDécryptage•8 min de lecture
Être nommé, être recommandé, être cité : trois visibilités différentes dans les réponses des IA
Le marché range sous un même mot trois phénomènes qui n'ont presque rien en commun. Les études publiques disponibles montrent pourquoi il faut les mesurer séparément, et pourquoi une capture unique ne prouve rien.
AnalysesDécryptage•7 min de lecture
Ce qui fait varier la qualité d'une réponse d'IA : le cadrage, pas l'outil
Dans notre campagne, l'écart entre une demande brute et une demande cadrée atteint 1,2 point de qualité. L'écart entre les cinq assistants testés, à cadrage égal, n'en fait que 0,5.
AnalysesDécryptage•6 min de lecture
Le gain de temps de l'IA existe, mais il est petit et inégal
5,1 minutes de gain net moyen par expérience, 19 tâches gagnantes sur 20, et une tâche où l'assistance coûte 3,6 minutes de plus. La moyenne ne dit presque rien.
AnalysesDécryptage•6 min de lecture
Plus la tâche engage une décision, moins l'assistance est fiable
De la production de contenu à la décision stratégique, la qualité passe de 3,95 à 3,04 sur 5 et la supervision requise grimpe de 2,07 à 3,40. La pente est régulière.
AnalysesDécryptage•6 min de lecture
Les erreurs qui coûtent cher sont celles que personne ne voit
Sur les expériences où une anomalie avait été volontairement placée, 25 sur 45 sont passées inaperçues. Le sujet du contrôle n'est pas la qualité moyenne, c'est le trou.
AnalysesDécryptage•7 min de lecture
Deux évaluateurs, deux verdicts : pourquoi juger une IA est difficile
Sur le sous-échantillon doublement évalué de notre campagne, deux évaluateurs à l'aveugle tombent d'accord sur le verdict dans 56,7 % des cas. La mesure est moins stable que le résultat qu'elle prétend établir.